算法生成与声学处理的深度融合
音乐创作领域正经历从单纯的手工编排向算法辅助生成的范式转移,AI自动编曲系统通过深度学习海量音乐数据,能够实时生成符合和声逻辑与旋律走向的伴奏骨架。这种技术并非替代音乐人的创意,而是作为高效的初始素材生成器,大幅压缩从构思到成品的时间周期。与此同时,数字信号处理(DSP)技术扮演着声音塑造的关键角色,它负责将原本干瘪的数字音频信号转化为具有空间感、动态范围和特定音色特征的声学实体。
当编曲算法生成的音符序列与DSP引擎的深度处理相结合,音乐作品便不再局限于录音棚内的静态听感。DSP技术中的卷积混响、物理建模合成以及动态范围控制,能够精确模拟不同声学环境下的声波传播特性。这种结合使得每一首自动生成的曲目都能根据演出场景的物理条件进行实时适配,为后续打造高沉浸感的视听体验奠定了坚实的技术与数据基础。
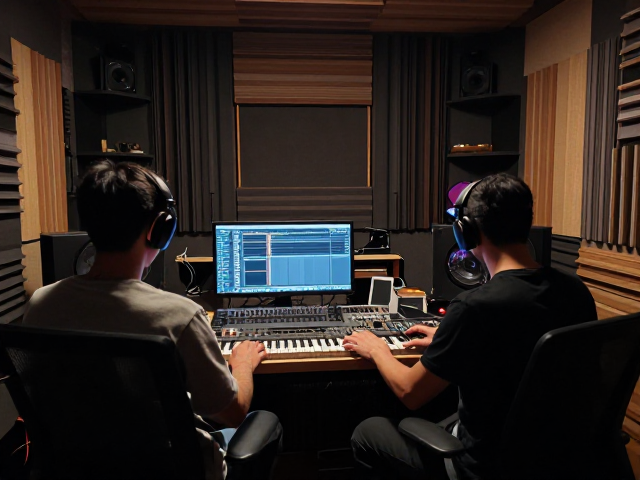
场景自适应的声学环境构建
在大型演出或沉浸式空间中,固定的声学参数往往难以应对复杂多变的环境干扰。AI编曲系统会实时监测现场音频反馈,结合DSP算法动态调整频率响应与相位特性,从而消除驻波、抑制反馈啸叫,确保声音的清晰度与纯净度。这种自适应处理使得音乐能够完美融入建筑空间,无论是空旷的音乐厅还是狭窄的Livehouse,都能通过算法计算出口现的最优声学解决方案。
沉浸式体验的核心在于听觉上的包裹感,这依赖于多声道音频矩阵与DSP延迟管理的精密配合。通过AI分析编曲中的乐器层次,DSP系统可以将不同声部分配到特定的声道或扬声器阵列,利用精确的时间差和强度差构建三维声场。听众在移动过程中,声音的定位与融合效果保持稳定,这种技术细节极大地增强了表演的真实感,使观众仿佛置身于音乐发生的原始场景中。
实时交互与动态演出呈现
传统演出中,音乐的结构往往是预设且固定的,而AI与DSP的结合引入了动态变化的可能性。在表演过程中,系统可以根据观众的反应数据或现场传感器输入,实时修改编曲的织体密度、节奏型甚至和声色彩。DSP技术确保这些实时修改不会破坏声音的连贯性,通过无缝的淡入淡出和参数平滑处理,实现音乐情绪的自然过渡。这种互动性打破了表演者与观众之间的隔阂,使演出成为一场双向互动的艺术体验。
此外,实时音效处理允许表演者在演奏过程中即时改变音色特征,例如从干声直接转换为巨大的空间混响,或通过DSP效果器改变乐器的物理属性。这种即时反馈机制极大地丰富了表演的表现力,使得每一次演出都具有独一无二的现场特质。AI编曲引擎能够根据表演者的输入即兴生成后续段落,再由DSP进行风格化渲染,这种人机协作的模式重新定义了现场音乐创作的边界。
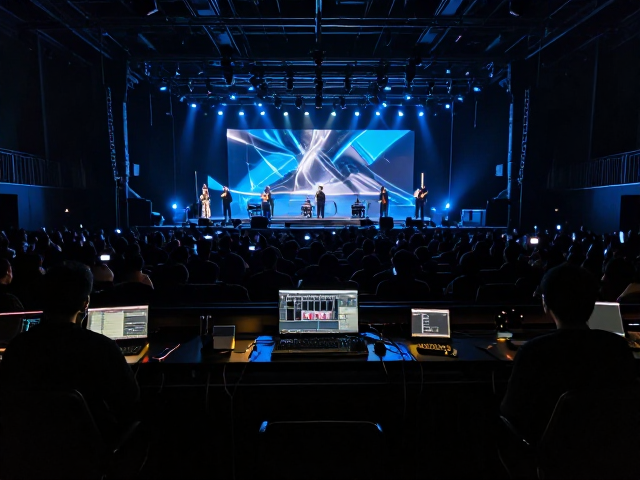
技术落地与行业应用现状
目前,多项专业音频设备与软件平台已广泛采用AI辅助编曲与高级DSP处理技术,部分主流DAW(数字音频工作站)中内置的AI助手功能可自动生成贝斯线或鼓点,并结合内置的旗舰级效果器链进行混音处理。在商业演出领域,一些大型音乐节已尝试使用基于空间音频技术的系统,通过预计算的DSP参数优化全场声场分布,确保不同区域的听感一致性。这些实际应用案例表明,技术融合已从理论探索走向规模化落地。
随着硬件算力的提升和算法模型的优化,实时AI编曲与DSP处理的延迟问题已得到显著改善,延迟时间普遍控制在毫秒级别,满足了现场表演的严苛要求。教育机构与专业工作室也开始引入相关工具进行创作教学,帮助从业者理解算法逻辑与声学原理。这种技术普及不仅提升了内容生产的效率,也推动了声学工程与音乐创作的跨学科融合,为未来更多元化的视听艺术形式提供了技术支撑。