物理建模在采样数据生成中的核心定义与价值
物理建模驱动采样引擎并非简单的数据插值工具,其核心在于利用系统内在的动力学方程或状态空间模型,还原物理过程的真实演化轨迹。通过建立包含质量、刚度、阻尼或热力学参数等关键变量的数学模型,引擎能够在未直接观测到的状态下,基于已知的边界条件推导出高置信度的数据点。这种机制从根本上解决了传统随机采样在复杂工况下分布不均、局部特征缺失的问题,使得生成的采样库能够严格遵循物理守恒定律与系统约束。
构建高精度采样库的关键在于模型对系统非线性特征与瞬态响应的捕捉能力。当物理模型能够精确描述变量间的耦合关系时,采样引擎便不再依赖海量的历史数据堆砌,而是通过模型推理在特征空间中进行“有向”探索。这种方式确保了采样点在物理意义上的一致性,避免了因数据噪声或离群值导致的模型训练偏差,从而为后续的分析、仿真或控制策略提供具备真实物理背景的高质量数据基础。
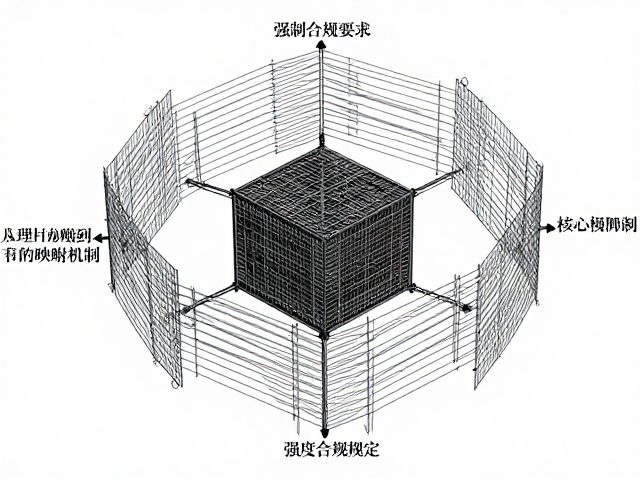
核心逻辑:从机理约束到有效采样的映射机制
采样引擎的核心逻辑建立在机理约束与采样效率的平衡之上。引擎首先解析物理模型中的状态空间,识别出对系统输出影响显著的关键变量及其分布范围。在此基础上,算法利用模型预测值作为先验信息,引导采样过程向高概率密度区域或高灵敏度区域集中。这种机制避免了盲目搜索,使得采样点能够精准覆盖系统动态变化的敏感区间,从而以最小的采样数量获得最大的信息增益。
在具体执行层面,引擎通过残差分析不断修正采样策略。当模型预测值与实际观测值或理论极限存在偏差时,采样引擎会自动调整步长或探索方向,以填补模型认知与真实物理行为之间的缝隙。这种闭环反馈机制确保了采样库不仅包含常规工况数据,还能覆盖极端工况或边界情况。通过物理逻辑引导的数据生成,采样库在保持数据稀疏性的同时,实现了信息密度的最大化,为复杂系统的建模与分析提供了结构化的数据支撑。
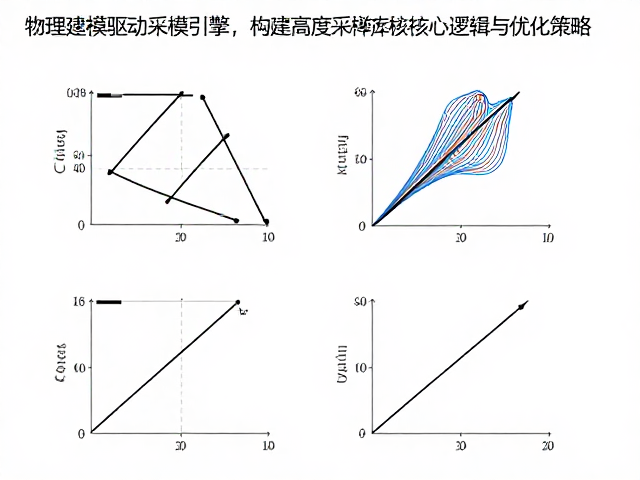
优化策略:自适应步长与分布均衡算法
为了提升采样效率,自适应步长优化策略会根据局部曲率或梯度变化动态调整采样密度。在系统变化平缓的区域,引擎采用较大步长以减少冗余数据;而在非线性显著或动态响应剧烈的区域,则自动加密采样点以捕捉细微变化。这种策略有效控制了采样库的数据规模,防止因过度采样导致的存储冗余和计算资源浪费,同时保证了数据分布与物理过程的一致性。
分布均衡算法进一步确保了采样库在多维特征空间中的代表性。通过引入最大最小距离优化或核密度估计方法,引擎对已生成的采样点进行去重与修正,消除聚类现象,使数据点尽可能均匀地分布在可行域内。此外,结合蒙特卡洛方法与确定性优化算法,引擎能够在满足物理约束的前提下,探索特征空间的边缘地带,确保采样库能够全面反映系统在各种潜在状态下的行为特征,提升数据的泛化能力。
技术实现:模型降维与并行计算架构
面对高维物理模型带来的计算瓶颈,模型降维技术成为技术实现的关键环节。通过主成分分析或物理本征正交分解等方法,引擎提取系统的主要模态或关键特征,将高维状态空间映射到低维子空间中进行采样。这一过程大幅降低了计算复杂度,使得引擎能够在实时或近实时场景下运行,同时保留了物理过程的核心动态特性,确保了采样结果的准确性与可解释性。
并行计算架构的引入进一步提升了引擎的处理能力。通过将采样任务分解为多个独立子任务,并利用多核处理器或分布式计算集群进行并行执行,引擎能够显著缩短大规模采样库的构建时间。结合高效的内存管理策略,系统能够处理百万级甚至千万级的采样点生成任务,满足工业级高精度数据需求。这种技术架构使得物理建模驱动采样引擎能够应对复杂系统的大规模数据分析挑战,为高精度采样库的构建提供了坚实的技术保障。