交互式音景重构景区声场叙事逻辑
传统景区演艺长期面临“听”与“看”割裂的困境,游客往往处于被动接收状态,难以与表演内容产生深层情感链接。交互式音景技术通过空间音频定位与实时响应系统,将声音从背景陪衬转变为叙事主体。当游客移动至舞台左侧,声场会自动调整人声比例与混响特征,使声音像水流般跟随行踪变化。这种技术并非简单的音量调节,而是基于声学掩蔽效应与哈斯效应的精细化计算,确保每一首曲目、每一句台词都能精准覆盖目标区域,同时避免不同声区的相互干扰。
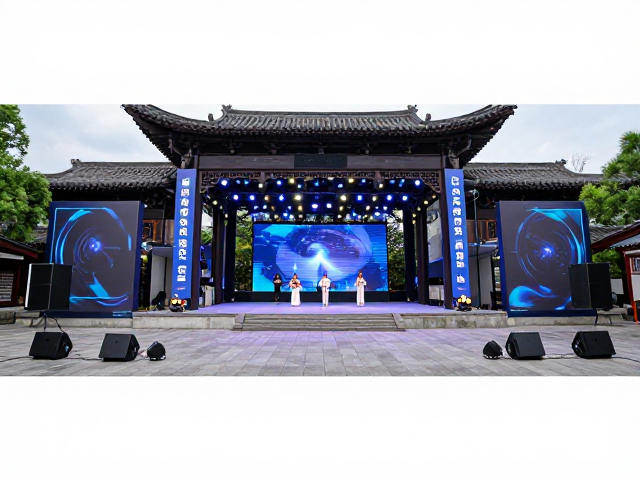
在大型山水实景演出中,分布式扬声器阵列配合定向声束技术,实现了“声随人动”的沉浸效果。例如,在部分采用400米以上长卷式舞台的项目中,通过部署超过200个独立声源点,系统能根据游客在观景平台的具体坐标,动态生成个性化的听觉视角。游客不再需要寻找最佳听音位,因为无论站立何处,系统都能通过算法补偿距离衰减与环境噪声,提供清晰且富有层次感的声场体验。这种去中心化的声场设计,打破了传统剧场“前排优于后排”的声学局限,让每一位参与者都成为声景构建的一部分。
便携装备赋能个体化沉浸入口
随着可穿戴设备与个人终端的普及,景区演艺正从“群体围观”向“个体专享”延伸。轻量化骨传导耳机与智能导览终端成为连接游客与演艺内容的关键载体。不同于传统降噪耳机,骨传导技术允许用户在接收高清演艺音频的同时,保留对周围环境声的感知,既保证了沉浸感,又兼顾了户外安全。部分景区已试点通过蓝牙低功耗协议,将演艺现场的实时音频流同步至游客个人设备,实现音画同步的私人视角体验。
智能装备还承载着环境互动的数据反馈功能。内置陀螺仪与加速度传感器的便携终端,能识别游客的行走速度、停留时长甚至肢体动作,将这些行为数据实时回传至后台控制系统。例如,当系统检测到某区域游客驻足时间超过阈值,会自动增强该区域的环境音效或触发隐藏的剧情线索。这种双向交互使得演艺内容不再是单向输出,而是根据群体行为实时演变的动态过程。设备的小型化与低功耗设计,使得游客无需携带沉重设备,即可在长时段游览中持续获得高质量的视听反馈。
技术架构支撑实时渲染与低延迟传输
实现高水准的沉浸式体验,依赖于严密的底层技术架构支撑。交互式音景的核心在于实时音频渲染引擎,它能够根据游客位置、环境噪声值、天气状况等多维数据,每秒进行数千次参数计算。为了确保声音的连续性与无断裂感,系统必须具备极低的传输延迟。目前主流的解决方案采用5G专网或Wi-Fi 6E环境,将端到端延迟控制在20毫秒以内,这一数值远低于人类听觉对声音断点的感知阈值,从而营造出声音与画面、动作无缝跟手的真实感。
数据处理的边缘化趋势也在这一领域显现。将部分音频计算任务从云端下沉至景区本地的边缘计算节点,有效降低了网络波动对体验的影响。通过在景区内部署高性能服务器集群,实时处理来自成千上万个传感器与终端的数据请求,确保在高峰时段依然能维持稳定的交互响应。此外,声学模型的动态更新机制会根据季节、植被变化甚至湿度影响,定期校准声音传播模型,使技术系统能够适应户外环境的复杂多变,保持演艺体验的一致性与稳定性。