颗粒合成的声学原理与时间拉伸机制
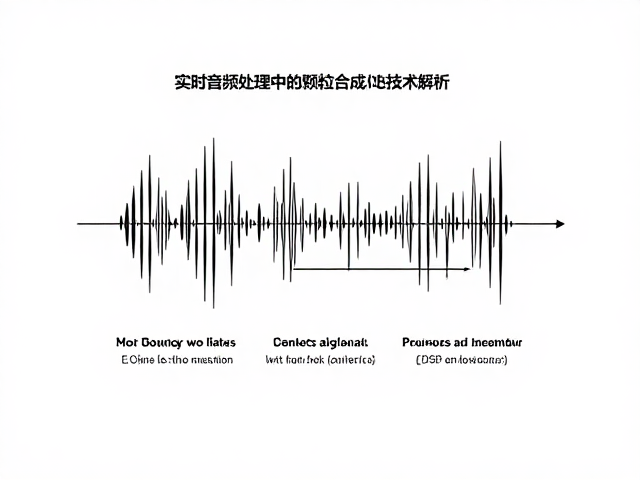
颗粒合成(Granular Synthesis)的核心在于将音频信号分割为极短的片段,通常时长在1到100毫秒之间,这些片段被称为“颗粒”。当大量这样的颗粒以不同的时间偏移、音高和音量重新组合时,人耳会将离散的声音事件感知为连续的音流或复杂的纹理。这种技术突破了传统减法合成或加法合成对波形完整性的依赖,使得音频处理能够在微观尺度上对声音形态进行重塑。在实时处理场景中,关键在于如何以极低的延迟管理这些颗粒的生成与调度,确保音频流的连贯性,避免产生可察觉的断点或爆音。
时间拉伸是颗粒合成在实时DSP应用中最重要的功能之一,它允许在不改变音高的情况下调整音频的速度,反之亦然。传统的相位 vocoder 方法虽然能处理长片段,但在实时性和极端拉伸比例下常出现金属感或模糊效应。颗粒合成通过控制颗粒间的重叠窗口和包络形状,能够更灵活地管理相位一致性。现代算法通常使用重叠添加法(OLA)或重叠保存法(OLS),通过精心设计的窗口函数(如汉宁窗或高斯窗)来平滑颗粒边界,从而在保持原始音色特征的同时实现平滑的速度变化。
DSP处理器在实时系统中的架构挑战
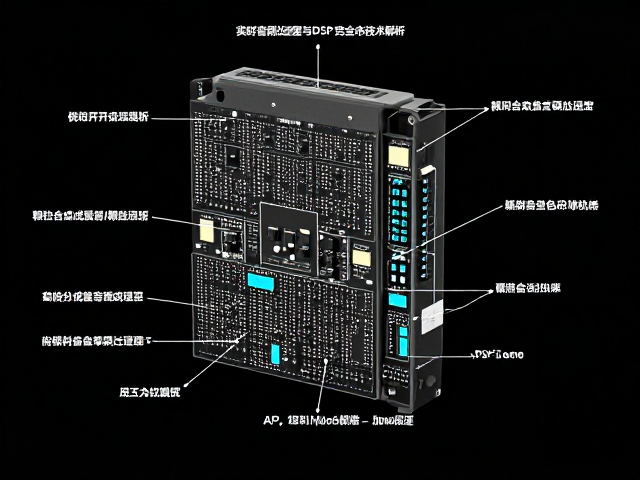
实时音频处理对处理器架构有着严苛的要求,主要体现为对确定性延迟和吞吐量管理的需求。DSP处理器通过哈佛架构或改进的哈佛架构,将程序存储器和数据存储器分开,允许同时取指和读写数据,这显著提升了音频样本的处理效率。在实时颗粒合成中,处理器必须能够在每个采样周期或极短的块内完成加法、乘法、延迟线和包络生成等操作。为了降低功耗并提高能效,现代DSP常采用 SIMD(单指令多数据)指令集,一次性对多个样本执行相同操作,从而在有限的时钟周期内处理更长的音频块,减少CPU负载。
内存管理是实时DSP系统中的另一大挑战,特别是在处理大规模颗粒库或动态生成颗粒时。频繁的内存分配和释放会导致不可预测的延迟,破坏实时音频流的稳定性。因此,高效的DSP实现通常采用预分配的环形缓冲区(Ring Buffer)或双缓冲机制来管理音频数据流。这种静态内存分配策略消除了动态内存分配的不确定性,确保音频中断服务程序(ISR)能以固定的时间间隔触发。此外,硬件乘法累加器(MAC)单元的存在使得复杂的滤波和卷积运算能够以极高的吞吐量完成,为实时颗粒合成提供了必要的计算密度支持。
实时延迟管理与缓冲区策略
在实时音频链路中,总延迟由输入ADC、DSP处理、输出DAC以及操作系统调度共同决定,其中DSP处理部分的确定性至关重要。颗粒合成算法需要精确计算每个颗粒的起始时间和结束时间,这涉及到复杂的队列管理。如果缓冲区过大,虽然能容纳更多的计算步骤,但会增加系统的整体响应延迟,导致音画不同步或交互体验下降;反之,过小的缓冲区可能导致缓冲区溢出(Underflow),引发音频断流和爆音。因此,开发者需根据应用场景的需求,平衡缓冲区大小与延迟表现,通常在交互式音乐应用中,目标延迟需控制在20毫秒以内。
为了优化延迟,许多实时音频框架采用零拷贝技术,直接通过指针访问音频数据,避免数据在内存中的冗余复制。同时,线程间通信和数据同步机制也需要精心设计。在多核DSP系统中,任务间的数据共享常通过无锁队列或原子操作来实现,以减少线程阻塞和上下文切换带来的开销。此外,动态调整颗粒大小和重叠率也可以作为一种自适应策略,在高负载情况下暂时减小颗粒数量或简化包络计算,以维持音频流的连续性,确保系统在资源受限的环境中仍能稳定运行。
算法优化与硬件加速实践
针对实时颗粒合成的计算密集型特性,指令级优化是提升性能的关键手段。利用DSP特有的位操作和饱和算术指令,可以高效处理音频样本的量化和动态范围控制。例如,在计算颗粒包络时,可以使用查表法替代复杂的浮点指数运算,将计算复杂度从浮点乘法降低为内存查找和加法操作。此外,循环展开和流水线填充等技术可以减少分支预测失败和流水线停顿,提高指令吞吐率。在嵌入式环境中,这些软件层面的优化往往能带来数倍的性能提升,使实时处理成为可能。
硬件加速单元在现代DSP中扮演着重要角色,特别是对于涉及大量乘加运算的滤波器或卷积操作。专用硬件加速器可以并行处理多个乘法累加指令,显著缩短处理时间。对于颗粒合成中的随机数生成和调度算法,某些高端DSP集成了硬件随机数发生器(HRNG),确保颗粒时间偏移和音高变化的统计特性符合设计要求,同时避免软件生成随机数带来的计算开销。通过结合软件算法优化与硬件加速特性,开发者能够在低功耗设备上实现高质量的实时颗粒合成效果,满足专业音频制作和交互式声音设计的需求。